モデルがそもそも上達する仕組み——坂を下る小さな一歩。
SRC·08
Source
モデルは書かれない。一歩ずつ、坂を下るように微調整される。
モデルの何十億もの設定を人が手で書くわけではない。モデルは自分でそれを見つける——どれだけ間違っているかを測り、すべてのつまみを少しだけ正しい方へひと押しする。これを百万回くり返せば、空っぽのネットワークが知性になる。この方法には素朴な名前がある——勾配降下法、自分の間違いという坂を下っていくこと。
一つの数字が「どれだけ外したか」を語る。そしてつまみは十億個。
学習はすべての間違いを一つの数字に押し込める——損失だ。低いほどよく、その値はすべてのつまみに同時に左右される。見渡すかぎり並ぶ、同じ形のバルブの壁のように:一つずつ回して組み合わせを試していたら、宇宙の寿命より長くかかる。総当たりでは探せない。必要なのは方向——いま、それぞれのつまみをどちらへ回すべきか、だ。
どっちが下り坂? 傾きに訊け。
一つのつまみについて、その傾きは損失がどちらへ登るか、そしてどれだけ急かを教える。すべてのつまみの傾きを一本の矢印にまとめれば、それが勾配——いちばん急な登り方だ。霧の中、靴底で斜面を読むように:山全体は見えなくても、足はどちらへ地面が傾くかを正確に感じ取る。かんたんに言えば:勾配とは、全つまみの傾きを一度にまとめ、最も急な登りを指す一本の矢印だ。
下りたい? なら矢印と逆向きに一歩。
勾配は登りを指す——いちばん行きたくない方だ。だから反転させる:いまのつまみを取り、逆向きに少しだけ踏み出す。そしてまた。さらにまた。ギターを調律するように:高すぎれば少し緩め、低すぎれば少し締める——一気に引っぱらず、つねに正しい音へそっと寄せる。かんたんに言えば:新しいつまみ=古いつまみ から 坂を下る小さな一歩(η)を引いたもの。この一行を百万回くり返すこと、それが学習そのものだ。
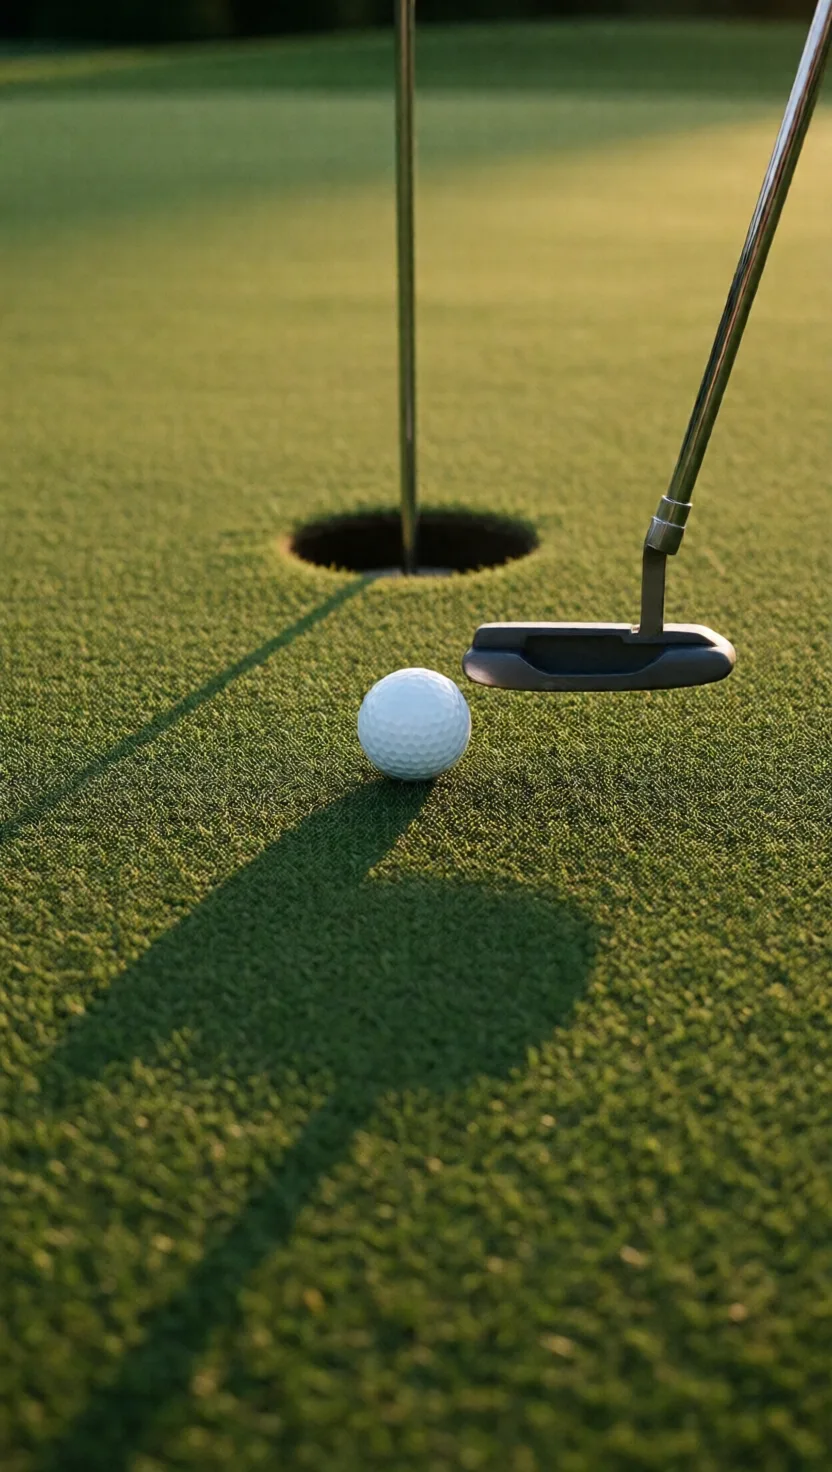
歩幅がすべて。大きすぎても小さすぎても失敗する。
その歩幅——η、学習率——こそ学習で最も重要なつまみだ。かんたんに言えば:坂を下る小さな一歩は、損失をおよそ(歩幅)×(急さ)² だけ下げる。正直で予測できる前進だ——ただし、この直線近似が通用するほど歩幅が小さいあいだだけ。パットのように:強く打ちすぎればカップをはるかに通り過ぎ、弱すぎれば手前で止まる。ちょうどよい力加減だけが、それを沈める。
毎歩すべての例を量るのは無理。だからひと握りで済ます。
本当の傾きを知るにはすべての訓練例を回す必要がある——毎歩やるには遅すぎる。そこで小さなバッチを無作為に取り、その傾きだけを平均する。一握りでコーヒー一袋を見極めるように:袋を全部あけたりしない——正直なひとすくいが残りを言い当てる。かんたんに言えば:傾きの、安上がりで揺らいだ当て推量だ——しかもその揺らぎが、浅いくぼみから抜け出す助けにすらなる。これが確率的勾配降下法だ。
これでエンジンの全部だ。地面が平らになったら、終わり。
名前をはがせば、学習はループする四つの動きだ:どれだけ外したか測り、傾きを読み、それに逆らって一歩進み、くり返す。何十億のつまみに、たった一つの規則。かんたんに言えば:勾配がゼロになったら到着だ——傾きはもう残らず、地面は平らで、下る先がない。その平らな場所こそ、歩み全体が向かっていた底だ。空っぽのネットワークが知性になった——そしてこれ、辛抱強く、目の見えない、執拗な降下だけが、それをそこへ連れていった。
🌱 でも、どの底? それは、どこから始めたかで決まる。
🌱 これほど広い地形には、谷は一つではなく、いくつもある。平らな地面はただある一つの底を意味するだけで、その底ではない——別の場所から始め、少し違う踏み出し方をすれば、まったく別の盆地に落ち着く。だから得られるモデルは、当てはまる唯一のものではない。あなたの道筋がたまたま落ち着いた先にすぎない。そもそも、ただ一つの本当の答えがあの底で待っているのか——それとも、あなたが転がり込んだ窪みと、そこへ導いた道があるだけなのか?
タップ →↑スワイプで詳しく↓スワイプで終了クリックまたは → で次へ↑ で詳しくesc で終了